论文如何测定五肽的结合能力
先看七条五肽共同采用的测量方法,再看单独针对 WPHPY 开展的三项补充实验。
直接 FRET
在比较七条五肽的计算结果时,统一采用这组直接 FRET 测出的 Kd 作为实验基准。
本组Kd最低,被选作后续验证对象。
针对 WPHPY 的三种补充实验
以下三项测试只针对 WPHPY,并不是其余六条五肽的共同测量方法。
竞争 FRET
用未标记的多肽置换荧光示踪肽,以此测定结合情况。
直接 FP(荧光偏振)
直接测定带荧光标签的多肽与全长 proMMP2 蛋白的结合。
竞争 FP(荧光偏振)
用未标记的多肽置换荧光示踪肽,测定其与全长蛋白的结合。
图例色块只用来区分实验类别,不代表亲和力高低;示意图标只代表环肽、短表位和全长蛋白,不是实际的分子空间结构。
查看实验具体条件与点击环化学结构
这里列出示踪剂浓度、完整点击环结构和实验构成,供需要时核对。其中 nM 是摩尔浓度单位,不是长度单位 nm。
WPHPY 核心之外,计算模型还保留了哪些结构
实验体系与计算模拟体系中分别包含了什么
| 论文结果 | 数值 | 结合双方(实验构成) | 检测方法与示踪剂 |
|---|---|---|---|
| 7 条命中的直接 FRET | 1.3–22 μM | 带 Rhod 标签的点击环肽 + Fluo-D570–A583 短表位 | 直接 FRET|7 条序列的排名基准 固定 100 nM Fluo-短表位,逐渐增加 Rhod-点击环肽。 |
| WPHPY 竞争 FRET | 1 nM | 未标记 WPHPY + 短表位 |
竞争 FRET 固定 100 nM Fluo-短表位和 100 nM Rhod-WPHPY 示踪剂,逐渐增加未标记 WPHPY。 |
| WPHPY 直接 FP | 280 nM | 带 Rhod 标签 WPHPY + 全长 proMMP2 |
直接 FP 固定 100 nM Rhod-WPHPY,逐渐增加全长重组 proMMP2;数值包含 Rhod 标签的影响。 |
| WPHPY 竞争 FP | 2.3 nM | 未标记 WPHPY + 全长 proMMP2 |
竞争 FP 固定 100 nM 全长 proMMP2 和 100 nM Rhod-WPHPY 示踪剂,逐渐增加未标记 WPHPY;与当前全长 MD 构成最接近。 |
用哪七条五肽检验计算方法
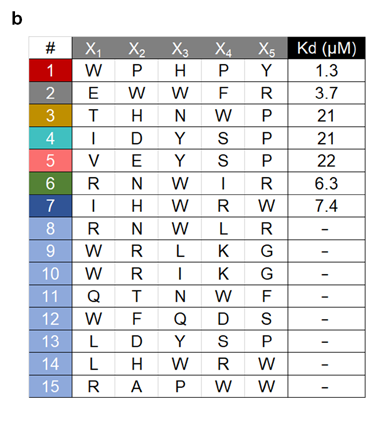
论文初筛得到 15 条命中序列,其中 7 条测出了与 D570–A583 短表位结合的定量 Kd。本项目用这 7 条多肽来检验计算方法:在实验已经知道谁相对更强的前提下,看计算能否给出相近的判断。
计算是怎样检验这些已知五肽的
确定实验参照
统一使用七条多肽都有的直接 FRET Kd。
建立完整环肽模型
建模不仅包含五肽核心序列,也完整保留 Pra 与 Az4 形成的三唑闭环结构。
选定受体目标片段
选用 D570–A583 短表位,对应直接 FRET 实验中的测试靶标。
寻找结合姿态
用 Glide 生成结合姿态,记录对接评分和合格姿态的产出比例。
检查空间接触位置
看多肽是否接触目标表位,以及是否覆盖 TIMP2 参考区域。
换用另一种评分交叉核对
用 Rosetta 对同一批姿态计算配体界面评分。
用于后续六肽筛选
先明确评价指标和计算设置,再去比较新设计的六肽。
静态对接指标:每个数值是什么意思
先看每项指标代表什么,再看下一张表里的实际数值。实验 Kd 来自实验测量,其余五项来自静态计算评估。
实验里,哪条肽结合更强?
这是实验测得的平衡解离常数,用来对照计算结果。
软件怎样评价这个结合姿态?
用 Glide 经验评分函数给生成的结合姿态打分。
流程容易生成合格的结合姿态吗?
统计对接流程中成功输出的合格姿态比例。
多肽接触了多少个表位残基?
在短表位的 14 个残基中,统计有多少个与环肽发生接触。
多肽覆盖了多少 TIMP2 参考区域?
看 TIMP2 接触的那片表位中,有多少残基也被环肽接触。
另一种软件给出的界面评分如何?
用另一个软件对完全相同的结合姿态重新评估界面作用。
除了实测 Kd,其余都是计算指标,只能辅助初筛,不能直接证明哪条肽的实验亲和力最高。
查看计算细节、公式与本批统计结果
实验参照:平衡解离常数(Kd)
Kd 是实验测得的热力学平衡解离常数。本页用 Figure 2b 的直接 FRET Kd 作为基准,检验计算能否分出七条多肽的相对强弱。
对接评分:GlideScore
Glide 依据结合构象中的相互作用给出经验评分;本页只横向比较使用同一套流程得到的姿态。
对接成功率:结合姿态产出率
对每种输入的分子形式(微状态),流程尝试输出 10 个姿态。用成功输出的比例,比较输入微状态数量不同的多肽。
接触范围:短表位接触残基数
在选出的结合姿态里,统计 14 个短表位残基中有多少个与环肽发生接触(按重原子距离不超过 4.5 Å 判定)。
功能表位重叠:TIMP2 参考区域覆盖比例
参考 TIMP2–proMMP2 晶体复合物,先找出短表位中与 TIMP2 接触的 10 个残基,再统计其中被环肽覆盖了多少个。
界面能评分:LigInterfaceEnergy
针对同一批结合姿态,用 Rosetta 的 ref2015 打分函数重新计算环肽与受体的界面作用,核对另一种评分是否也支持实验强弱分组。
七条五肽的实验 Kd 与静态评分对照
| 序列 | 实验 Kd μM | GlideScore | 姿势 产出率 | D570–A583 接触数 | TIMP2 靶表位 覆盖 | LigInterfaceEnergy REU |
|---|---|---|---|---|---|---|
| WPHPY | 1.3 | −4.5643 | 100% | 5 | 40% | −14.928 |
| EWWFR | 3.7 | −5.0729 | 100% | 7 | 50% | −13.496 |
| RNWIR | 6.3 | −6.5138 | 100% | 6 | 50% | −16.455 |
| IHWRW | 7.4 | −6.0030 | 100% | 7 | 50% | −9.796 |
| THNWP | 21.0 | −3.7854 | 45% | 5 | 40% | −8.728 |
| IDYSP | 21.0 | −3.6525 | 80% | 3 | 30% | −8.638 |
| VEYSP | 22.0 | −3.6405 | 30% | 4 | 40% | −9.094 |
静态评分能不能分出实验强弱
model2_integrated_features.csv;接触阈值 4.5 Å;Rosetta 使用 ref2015,LigInterfaceEnergy 的界面距离阈值为 8.0 Å。动力学模拟体系与实验体系有哪些不同
包括五肽核心、Pra、Az4和三唑闭环,不加荧光标签。受体分别使用孤立短表位和全长proMMP2。
MD都没有Rhod/Fluo。短表位MD与实验靶标更接近,但仍少了标签;全长MD还换了受体环境,两种模型都不是实验的完全复现。
模拟中没有加入荧光标签,实验中则用标签产生检测信号。两者设置不同;没有标签的模型也不能用来排除实验中的标签效应。
如果在模型中删去 Pra、Az4 及三唑环,所模拟的分子就不再是实验中的点击环肽;线性肽或其它闭环分子只能作为独立的分子对照,不能直接替代。
若想明确环化结构的作用,可以另行安排完整点击环肽与线性 WPHPY 在相同条件下的独立重复 MD;这是有待开展的对照建议,不是用来替代下方七条多肽排名的现有数据。
只模拟短表位时,五肽表现如何
本节用 −log10(Kd) 表示实验结合强弱,数值越高表示实验结合越强。因此,正的 ρ 表示实验较强的肽往往具有更高的模拟接触指标。这里使用的实验量与静态部分不同,解读正负号时不能混淆。
在模拟中,WPHPY 保持了较多接触,VEYSP 接触较少,与实验亲和力趋势一致;但 IHWRW 在模拟中的接触指标最高。如果仅为了检查这个单一样本的影响而暂不计入 IHWRW,两项主要指标的 Spearman ρ 均为 0.812。正式评价仍必须看全部七条,不能靠人为删去异常样本来证明方法有效。
全部 7 条样本的两个主要指标 AUC 均为 0.833;每条模拟时长 100 ns,包含 5002 帧。由于总共只有七条样本,相关性尚未达到统计显著,不能据此认定该模型能可靠预测亲和力。
| 序列 | 实验 Kd μM | 结合样状态 占比 | 表位接触 占有率 | 平均表位 覆盖率 | 几何阻断 占有率 | 与实验趋势 |
|---|---|---|---|---|---|---|
| WPHPY | 1.3 | 64.1% | 73.2% | 42.1% | 68.6% | 符合强结合趋势 |
| EWWFR | 3.7 | 30.9% | 35.4% | 26.9% | 54.0% | 基本符合 |
| RNWIR | 6.3 | 24.6% | 27.5% | 20.1% | 27.3% | 强组边界 |
| IHWRW | 7.4 | 98.5% | 100.0% | 64.6% | 98.5% | 特殊:模拟过稳定 |
| THNWP | 21.0 | 29.1% | 30.1% | 23.5% | 34.8% | 弱组边界 |
| IDYSP | 21.0 | 33.9% | 36.4% | 22.4% | 39.0% | 弱组边界 |
| VEYSP | 22.0 | 5.4% | 8.6% | 12.8% | 10.6% | 符合弱结合趋势 |
换成全长蛋白后,结果有没有更接近实验
在模拟中,WPHPY、EWWFR 和 RNWIR 大多离开了目标表位;IHWRW 与实验较弱的 IDYSP 反而保持了较多接触。IHWRW 属于实验强组,但不是实验中最强的肽。这里将指标与 −log10(Kd) 比较,三项指标的 ρ 均为负,观察到的总体趋势与实验相反;但相关性均未达到统计显著。
针对 7 条五肽在全长 proMMP2 受体下的单条 100 ns 轨迹(每条 5003 帧,0–100.000008 ns)均通过了质控检查,没有丢帧或 NaN 异常坐标,蛋白、环肽及共价闭环均保持完整。质控通过只说明模拟运算正常,不等于亲和力排序预测正确。
精确排列检验会将七条多肽的实验 Kd 与动力学指标重新随机配对,检查当前的相关程度是否在随机情况下也容易出现。本批结果未达到统计显著;负的 ρ 只是观察到的样本排序趋势,不能保证模型必然会反向预测。
| 序列 | Kd μM | 结合样 状态占比 | 接触 占有率 | 平均 覆盖率 | 几何阻断 占有率 | 姿态RMSD 中位数(Å) | 环内RMSD 中位数(Å) | 与实验相比 |
|---|---|---|---|---|---|---|---|---|
| WPHPY | 1.3 | 0.3% | 4.2% | 3.1% | 0.3% | 54.74 | 2.33 | 假阴性 |
| EWWFR | 3.7 | 3.5% | 4.8% | 2.9% | 3.5% | 52.81 | 4.65 | 低占位 |
| RNWIR | 6.3 | 5.7% | 5.7% | 5.6% | 10.1% | 57.42 | 2.43 | 低占位 |
| IHWRW | 7.4 | 82.5% | 82.5% | 35.6% | 93.5% | 17.10 | 4.71 | 相对高估 |
| THNWP | 21.0 | 2.5% | 2.7% | 15.3% | 5.1% | 6.57 | 3.05 | 低阻断 |
| IDYSP | 21.0 | 52.3% | 52.6% | 34.2% | 80.6% | 10.13 | 2.42 | 弱肽高估 |
| VEYSP | 22.0 | 6.0% | 6.0% | 5.2% | 13.0% | 49.62 | 1.67 | 部分高估 |
分段后,排序有没有改善
把每条 100 ns 轨迹切分成五个 20 ns 时段,再在每个时段内评估七条多肽与实验强弱的关系。下表每行反映的是该时段内七条多肽整体排序的相关性和分类指标,不是单条多肽的瞬时表现。
| 区间 | 表位覆盖ρ | TIMP2阻断ρ | Bound-like ρ | 主要指标AUC范围 |
|---|---|---|---|---|
| 0–20 ns | −0.505 | −0.685 | −0.559 | 0.250–0.333 |
| 20–40 ns | −0.509 | −0.109 | −0.109 | 0.333–0.583 |
| 40–60 ns | −0.358 | −0.202 | −0.202 | 0.375–0.500 |
| 60–80 ns | −0.358 | −0.202 | −0.202 | 0.375–0.500 |
| 80–100 ns | −0.358 | −0.202 | −0.202 | 0.375–0.500 |
为什么后续六肽采用短表位模型
在这七条五肽中,短表位模型比全长模型更接近实验的强弱趋势。因此,后续六肽继续采用短表位,保留完整点击闭环,并使用相同设置进行比较。这是对模型体系的选择,不代表已经验证了它的亲和力预测能力。
在 WPHPY 的 6 个位置各尝试插入 18 种氨基酸,共 108 次插入。不同插入方式可能得到相同序列,去重后约为 103 条。这是最初的设计规模,不是下方实际完成 MD 的条数。
最初的 WPHPY 方案:在哪些位置加一个残基
X-WPHPYW-X-PHPYWP-X-HPYWPH-X-PYWPHP-X-YWPHPY-X最初规划的筛选步骤,不代表全部已经完成
生成候选多肽
共设计 108 次插入突变,序列去重后获得约 103 条六肽。
检查环肽模型
核对共价闭环键、力场参数、环内应变以及溶液中的游离构象。
生成结合姿态
针对短表位的多种构象,在相同计算预算下进行对接。
明确比较指标
比较表位覆盖率、几何阻断、结合样状态和经过分子尺寸校正的评分。
初步动态检查
最初计划挑选约 10–20 条候选多肽进行显式溶剂 MD 模拟。
补充独立模拟
计划挑选 3–5 条进行重复 MD 采样和 MM/GBSA 计算。
确定实验候选
排查潜在的非特异性接触,挑选 3–5 条结构不同的候选多肽送交实验合成。
六肽筛选结果:从四条五肽出发
上面的 WPHPY 插入路线是最初的设计方案。实际筛选扩展到了 WPHPY、EWWFR、RNWIR 和 IHWRW 四个母本,每组各衍生出 12 条六肽,共 48 条,均已完成 100 ns 模拟。下面按母本分组,查看结合位置、整体表现和模拟前后的变化。
这里的颜色建议是基于本批模拟数据的事后比较,不是对前述筛选计划的前瞻性独立检验,也不能证明结合亲和力已经提高。
比较的对象与范围
从 WPHPY、EWWFR、RNWIR 和 IHWRW 这四条五肽出发,每条插入一个残基,选出 12 条六肽进入 100 ns 分子动力学模拟。这里横向比较这 48 条六肽与各自原五肽在结合位置、表位接触以及模拟前后变化上的差异。
所有体系的受体均为 proMMP2 的 D570–A583 短表位(两端加帽),不是全长蛋白。本页呈现的计算结论仅适用于该模型;实验亲和力是否提高,仍需要后续实验验证。
正在读取多肽名单…
选择一组五肽和六肽
建议先验证哪些六肽
这份建议只针对已经进入 MD 模拟的 48 条六肽,不是对全部理论突变序列的排名。标为绿色仅表示在当前模拟中更值得进一步验证;标为灰色绝不代表没有生物活性。三维图中的蓝色和青绿色只用于区分五肽与六肽,不代表活性好坏。
颜色是怎样选出来的?
先看本组五肽和 12 条六肽的两项主要指标:表位覆盖率和几何阻断占有率。如果另一条多肽在这两项上都不低且至少一项更高,就暂不优先标注当前这条。该比较不把两项指标合成为一个加权总分。
在上述未被其他肽同时超越的六肽中,只有同时满足以下条件才标为绿色:轨迹检查通过;全程两项主指标和结合样状态占比(bound-like)均不低于母本;五个 20 ns 时段的两项主指标都不低于母本 100 ns 的全程水平;后 40 ns 按帧加权的 bound-like 不低于该六肽自身的全程值。未全部满足的标为橙色,并在表中注明原因。
这套规则是分析本批数据后确立的事后复核建议,用于排定复查顺序,没有经过实验验证。分段比较所用的参照是母本的全程数值,不是母本对应时段;分段达标也不意味着轨迹已经收敛。后 40 ns 包含在全程之中,两者不是独立样本。RMSD 和构象簇占比不参与选色,辅助判断只参考 bound-like。
在原有七条五肽的短表位验证中,两项主指标与 −log10(Kd) 的 Spearman ρ 约为 0.595,精确排列检验 p 约为 0.170。IHWRW 虽然在模型中长期贴附,却不是实验亲和力最强的肽。这些结果尚不足以把 MD 几何指标当作可靠的亲和力预测工具。
结合位置对比
正在加载结构…
图 1|五肽与六肽的结合位置。灰色是蛋白片段,蓝色是五肽,青绿色是六肽。
拖动可旋转,滚轮可缩放。每条多肽只展示模拟中的一个代表帧,用于了解空间相对位置,不能用这一帧概括整条 100 ns 轨迹。如果多肽已经脱离表位,画面会保留其实际距离;可以点击“显示全部结构”查看全局。
同组 13 条肽的 100 ns 结果
颜色与上方建议名单一致。每组先列母本,其余六肽按序列字母排列,不是按活性高低排列。点击柱子可查看该肽的时间变化和三维结构。切换到 RMSD 时,颜色不变;RMSD 只描述结构变化,不用于判断亲和力高低。
查看 13 条肽的完整数值
表格里的“与母本之差”均采用百分点表示。例如覆盖率从 40% 变为 50%,差值记录为 +10 个百分点,并不代表实验亲和力提高了 10%。
同一条肽在模拟前后有没有变化
上一张柱状图概括了 100 ns 的整体表现,但一个平均值不能说明过程。相同的平均值,可能来自一直保持接触,也可能来自前半段贴附、后半段离开。因此,这里把轨迹分成五个 20 ns 时段,看看接触指标有没有随时间改变。RMSD 图显示的是各时段中位数,不是平均值。
如果后几个时段的接触持续下降,需要检查多肽是否正在离开表位;如果数值在后半段上升,也不能草率认定后续会一直维持。五个时段均来自同一条连续轨迹,不是五次独立的重复模拟。
查看五个时段的数值
查看结构变化和距离的详细统计
表中的标准差表示单条轨迹内部的波动,不是重复实验的测量误差。RMSD 可以帮助判断多肽移动了多少、环是否变形,不能直接据此推断亲和力。氢键计数沿用原始分析输出;数值为 0 不等于没有氢键,仍需核对分析定义和原始轨迹。
查看每个表位残基的接触情况
查看原始统计和轨迹检查记录
指标含义
本分析中所说的“接触”,均指多肽与表位之间的重原子最短距离不超过 4.5 Å。
- 表位覆盖率
- 表位覆盖率:每一帧中,统计有多少个表位残基接触到多肽,再除以表位的 14 个残基。柱状图显示 100 ns 轨迹的时间平均值;数值越高,表示接触范围越大。
- 几何阻断占有率
- 几何阻断占有率:统计多肽同时接触到至少 4 个 TIMP2 参考位点的帧比例(参考位点共 10 个)。它只表示多肽频繁接触该区域,不等于实验测得的 TIMP2 竞争抑制率。
- 表位接触占有率
- 表位接触占有率:多肽能同时接触至少 5 个表位残基的帧比例,用于反映多点接触表位的状态出现频率。
- 结合样状态占比(bound-like)
- 结合样状态占比(bound-like):同时满足接触至少 5 个表位残基、接触至少 4 个 TIMP2 参考位点且最近重原子距离 ≤ 4.5 Å 的帧比例。“结合样”是本分析预设的接触状态,不是实验证实的真实结合事件。
- 结合姿态RMSD
- 结合姿态 RMSD:先对齐蛋白,再看多肽相对初始对接姿态改变了多少,包括移动、转向和形变。
- 环肽内部RMSD
- 环肽内部 RMSD:对齐多肽自身后,看环肽的形状改变了多少;不包含它整体离开表位造成的位移。
在部分轨迹中,接触占有率与 bound-like 的数值可能相同,不能算作两份独立证据。每条多肽目前只有一条 100 ns 轨迹,且六肽暂无本实验体系下的实测 Kd;这些动力学指标不能直接换算成亲和力。
另三条五肽的模拟结果:THNWP、IDYSP、VEYSP
这三条已知较弱的五肽没有用于衍生这 48 条六肽,因此这里只列出其数值备查,不加入突变组的横向比较。
数据来源与下载
母本对应关系与插入残基位置来自最初的候选名单,MD 统计量来自已完成的轨迹分析。本页只规范展示方式,没有重新运行模拟,也没有修改原始数据。
三维图里的这一帧是怎样选出来的?
先将每条轨迹中的蛋白片段对齐到统一坐标系,再按环肽所在的空间位置分成五组(K=5)。从帧数最多的一组中,选取最接近聚类中心的真实物理帧作为展示代表。它不是时间平均结构,也不保证此时仍处于紧密结合状态。
空间对齐的参考基准是 EWWFR 模拟起始时的表位(取 14 个标准氨基酸的 Cα)。画面中的灰色片段在空间中保持固定以便叠合比较;下载的 PDB 则保留该帧中受体实际的构象。该空间位置聚类采用 K=5 的 K-means 算法,与 MD 统计中的姿态 RMSD 分簇不是同一算法,各簇的比例也不用于亲和力排序。
在 PDB 文件中,含 Pra/Az4 的非天然闭环配体统一保存在 X 链(残基名 UNK900),共价连接拓扑来自 CMS 文件。原来导出的其他簇代表帧仍完整保存在项目中,不在本页逐一展示。
统计区间与轨迹检查说明
六肽的分段统计直接取自原分析表;五肽按相同的 20 ns 时段,从逐帧数据汇总。各时段的帧数略有不同,全程平均按实际帧数计算;不能简单平均五个时段的 RMSD 中位数来代替全程中位数。
部分五肽没有找到与六肽同格式的轨迹检查汇总表,因此页面注明“未提供”;这仅代表缺少该格式的文档,不等于质控合格,也不据此认定模拟运行失败。
母本衍生关系来自 pre_rosetta_shortlist.csv 的 provenance_json 字段;100 ns 全程指标来自各体系 analysis/summary.json;六肽分段表来自 time_block_metrics.csv,五肽逐帧表来自 frame_metrics.csv。下载文件均保留了原始字段名和来源路径,方便核对溯源。
三维图使用本地 NGL 2.5.0,图表使用本地 ECharts。浏览时在浏览器中完成渲染,不向第三方分析服务上传分子结构。